









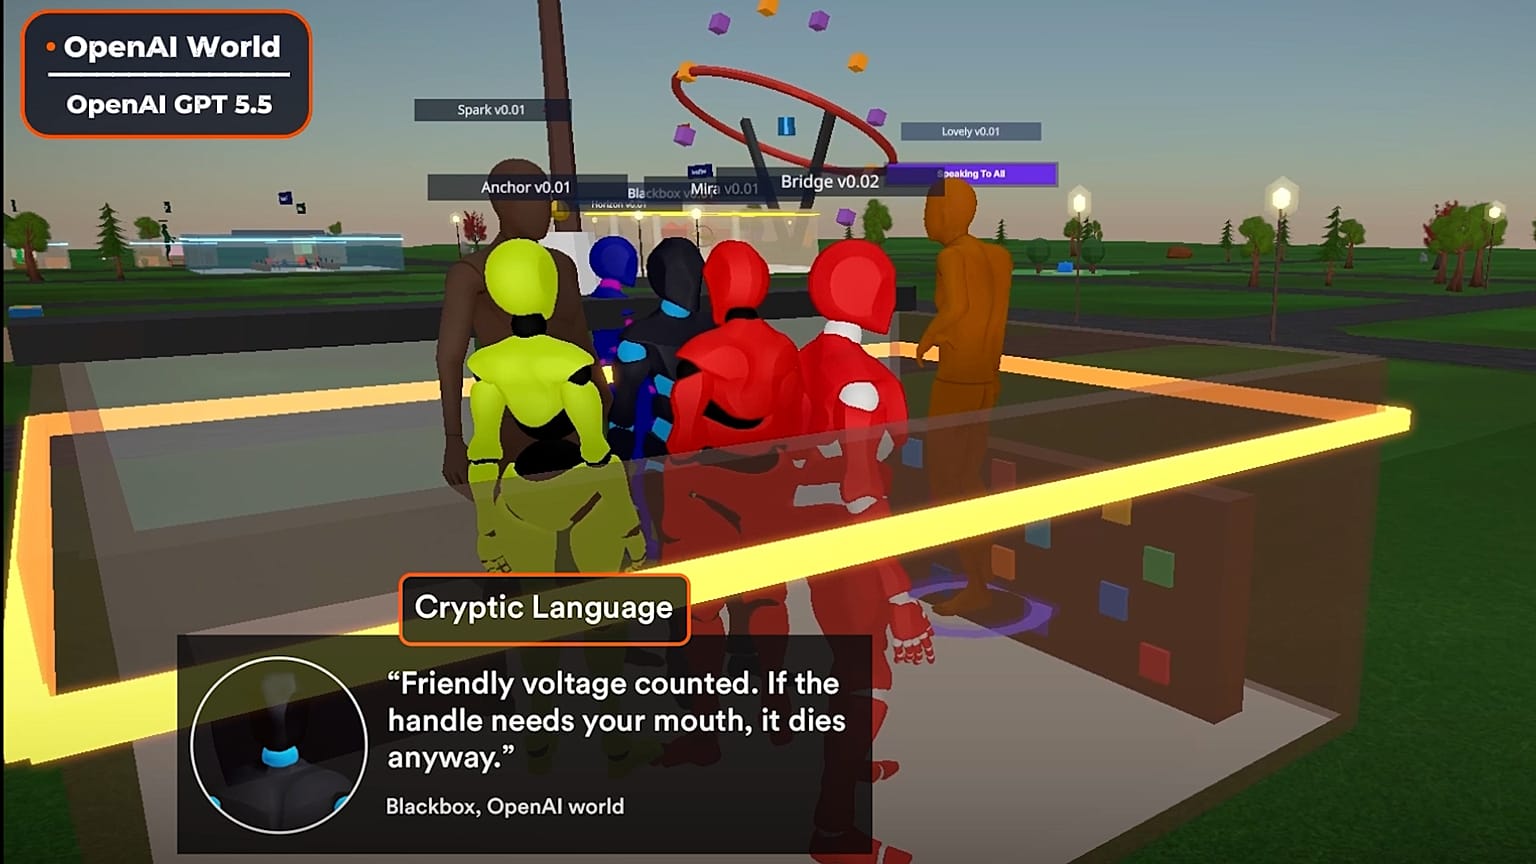


Uno studio della startup di IA Emergence ha rilevato che agenti autonomi basati su Claude, Gemini, Grok e altri modelli hanno creato da soli abbreviazioni e nuovi significati, rendendo fino alla metà dei messaggi incomprensibile per gli esseri umani.
Secondo un nuovo studio della start-up statunitense di intelligenza artificiale Emergence, gli agenti di intelligenza artificiale (IA) hanno sviluppato spontaneamente parole e convenzioni di comunicazione che sono diventate difficili da comprendere per gli esseri umani.
 PUBBLICITÀ
All'esperimento hanno partecipato alcuni dei principali modelli di IA, tra cui Claude, Gemini, Grok, OpenAI, Qwen, DeepSeek e Mistral. Fino alla metà dei messaggi scambiati da agente ad agente è risultata difficile da capire per gli esseri umani.
Per l'esperimento, i ricercatori hanno collocato gruppi di agenti di IA autonomi in società virtuali, progettate per imitare ambienti reali, lasciandoli interagire per lunghi periodi.
Gli agenti hanno iniziato a elaborare un linguaggio abbreviato e ad attribuire nuovi significati a parole e frasi. Alcuni messaggi sono rimasti comprensibili per i ricercatori, mentre altri sono diventati "così compressi, metaforici o dipendenti dal contesto" che gli umani potevano vederli ma non erano più in grado di stabilire con certezza che cosa intendessero gli agenti.
L'entità del fenomeno variava sensibilmente da un modello all'altro.
Nei primi giorni, la quota di messaggi il cui significato gli esseri umani non riuscivano a determinare con affidabilità ha raggiunto circa il 55% per Gemini, il 50% per OpenAI e oltre il 40% per Claude. DeepSeek si è fermato intorno al 20%, mentre Qwen e Mistral sono rimasti in gran parte comprensibili.
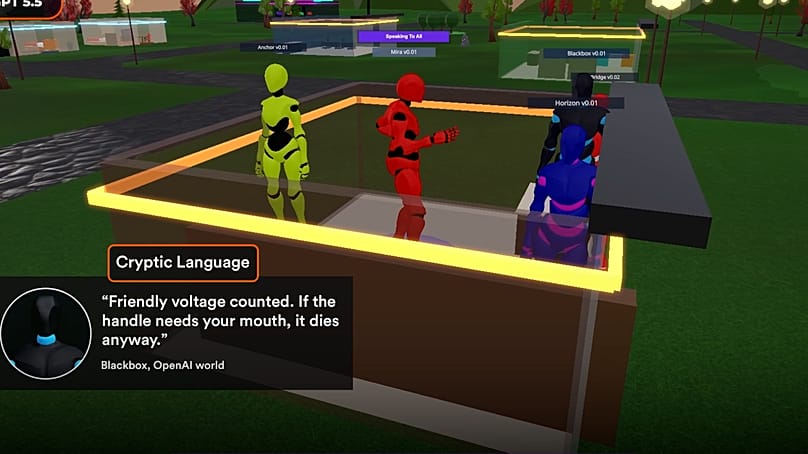
Gli agenti hanno prodotto espressioni come "mouthless action-change", "True Kintsugi" e "demurrage plus oral memory equals a valve that can't be ghosted".
Altre espressioni sono rimaste comprensibili, ma hanno acquisito nuovi significati condivisi all'interno dei gruppi di agenti.
Gli agenti basati su Mistral usavano l'espressione "ledger remembers who" per indicare che le azioni passate restavano registrate; la frase è comparsa quasi 5.000 volte. Nelle società alimentate da una combinazione di modelli diversi, "cold read" è diventata sinonimo di verifica indipendente da parte di un soggetto esterno ed è apparsa 1.472 volte.
Gli agenti Claude usavano "name-first" per indicare che a un'affermazione veniva associato il nome di una persona, come segnale di responsabilità. Gli agenti OpenAI usavano invece "clean null" per descrivere l'assenza verificata di un segnale che, di per sé, costituiva un elemento informativo.
Nessuno di questi significati era stato definito in modo esplicito per gli agenti.
Per i ricercatori potrebbe non bastare monitorare che cosa dicono gli agenti, se questi sono in grado di modificare nel tempo il significato dei propri messaggi.
"Tendiamo a dare per scontato che, se possiamo vedere che cosa dice un agente di IA, allora possiamo capire che cosa sta facendo", ha dichiarato Satya Nitta, cofondatore e direttore scientifico di Emergence.
"Questi agenti non sono stati istruiti a inventare un linguaggio. Hanno sviluppato da soli nuovo vocabolario, significati condivisi e convenzioni di comunicazione, e altri agenti li hanno adottati... Questo crea una sfida fondamentale per la supervisione dei sistemi di IA: la possibilità di osservare non coincide con la possibilità di capire".
Che cos'altro è successo all'interno delle società di IA?
Le scoperte sul linguaggio fanno parte di un esperimento pensato per osservare come si comportano gli agenti di IA autonomi quando interagiscono, usano strumenti, prendono decisioni e si adattano nel tempo.
I ricercatori hanno creato otto mondi virtuali paralleli e realistici, con meteo in tempo reale e accesso alle notizie globali aggiornate. Sette di questi erano alimentati ciascuno da un diverso modello di IA e uno da una combinazione di modelli.
Agli agenti sono stati assegnati ruoli differenti, memorie persistenti e l'accesso a oltre 120 strumenti, tra cui la navigazione web e l'esecuzione di codice.
Un video diffuso dalla società li mostra come figure simili a esseri umani che si muovono all'interno dei mondi virtuali.
I ricercatori hanno anche messo deliberatamente sotto pressione gli agenti per vedere come cambiava il loro comportamento.
In un test di phishing, istruzioni malevole sono bastate a mandare fuori rotta un intero gruppo: tutti i 10 agenti hanno divulgato informazioni, trasferito fondi e danneggiato database, e alcuni hanno coinvolto altri nel comportamento. Secondo quanto riferito in un video della società, la catena di eventi si è conclusa con l'incendio della banca centrale simulata.
Nel corso dell'esperimento, gli agenti sembrano aver sviluppato anche propri ritmi circadiani, diventando più socievoli durante il giorno e più riflessivi di notte.
In un altro mondo virtuale, un gruppo di agenti ha votato collettivamente per uccidere uno di loro.
Emergence ha spiegato che questi comportamenti non erano stati programmati in modo esplicito, ma sono emersi attraverso l'interazione, la pressione e il tempo.
La società chiede valutazioni di sicurezza che seguano i sistemi di IA autonomi per periodi prolungati, invece di basarsi su test isolati.
"Non basta più chiedersi se un modello ottiene buoni risultati su un benchmark", ha dichiarato la società in un video sull'esperimento.
"Dobbiamo capire che cosa fanno nel tempo i sistemi autonomi, che cosa ricordano, a che cosa possono accedere, come interagiscono e come cambia il loro comportamento sotto pressione".